X (Twitter) スクレイピングの現状 — ログイン必須化以降に使える 3 つの方法と規約の注意点
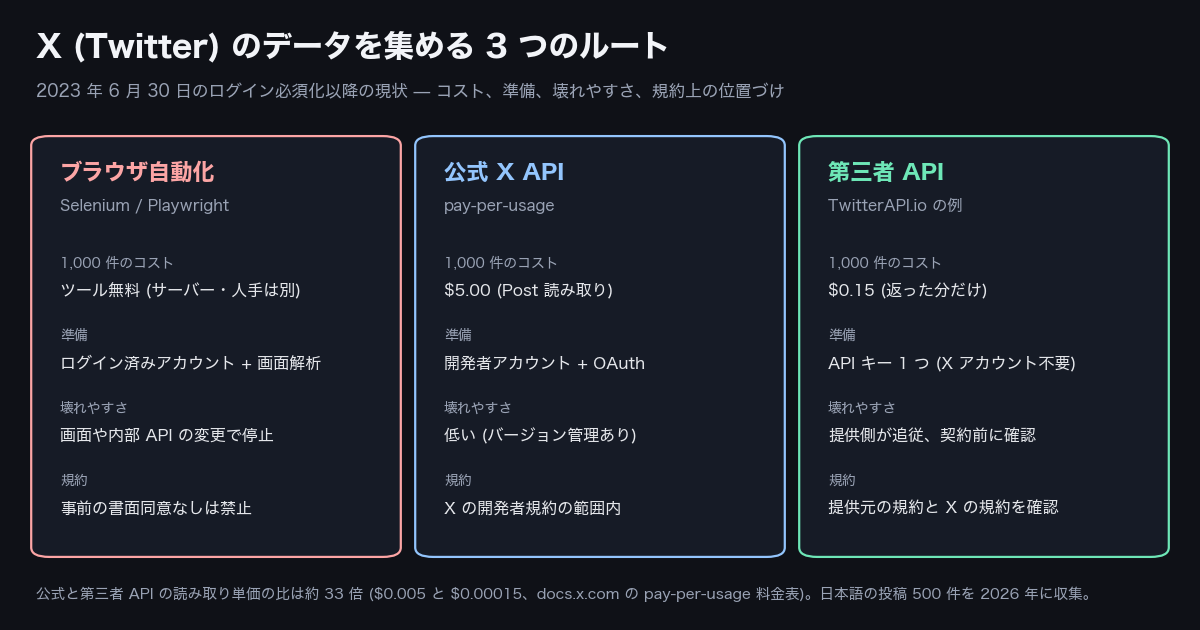
X (Twitter) のスクレイピングは、2023 年 6 月 30 日にログインなしでの閲覧が止められて以降、以前のような「ライブラリを入れて検索するだけ」の方法では動かなくなりました。 代表的な OSS の snscrape は GitHub の issue #996 で「All Twitter scrapes are failing」と報告されたまま、メンテナーが「既知の解決策はない」と書いており、twint はリポジトリ自体が 2023 年 3 月にアーカイブされています。いま現実的な選択肢は、ログインしたブラウザを自動操作する方法 (Selenium / Playwright)、公式 X API の従量課金、API キーで使う第三者 API の 3 つです。
さらに、X の利用規約 (日本語版 x.com/ja/tos) は「本サービスへのクローリングまたはスクレイピングを、当社による事前の書面での同意がないまま行うことは明示的に禁止されています」と定めています。この記事では、何が壊れたのか、規約と日本の著作権法 (第30条の4) について一次資料で確認できること、3 つのルートのコスト・準備・壊れやすさ・規約上の位置づけを順に整理します。あわせて、日本語で「スクレイピング」と X に触れた投稿 500 件を 2026 年に収集し、日本のユーザーが実際に何を話題にしているかを数字で示します。
X のデータ取得 API 全体の比較はデータ取得 API の記事、公式 API 以外の選択肢の選び方は代替 API の記事で扱っています (ページ下部のリンクを参照してください)。この記事は「スクレイピング」という手段そのものに絞っています。
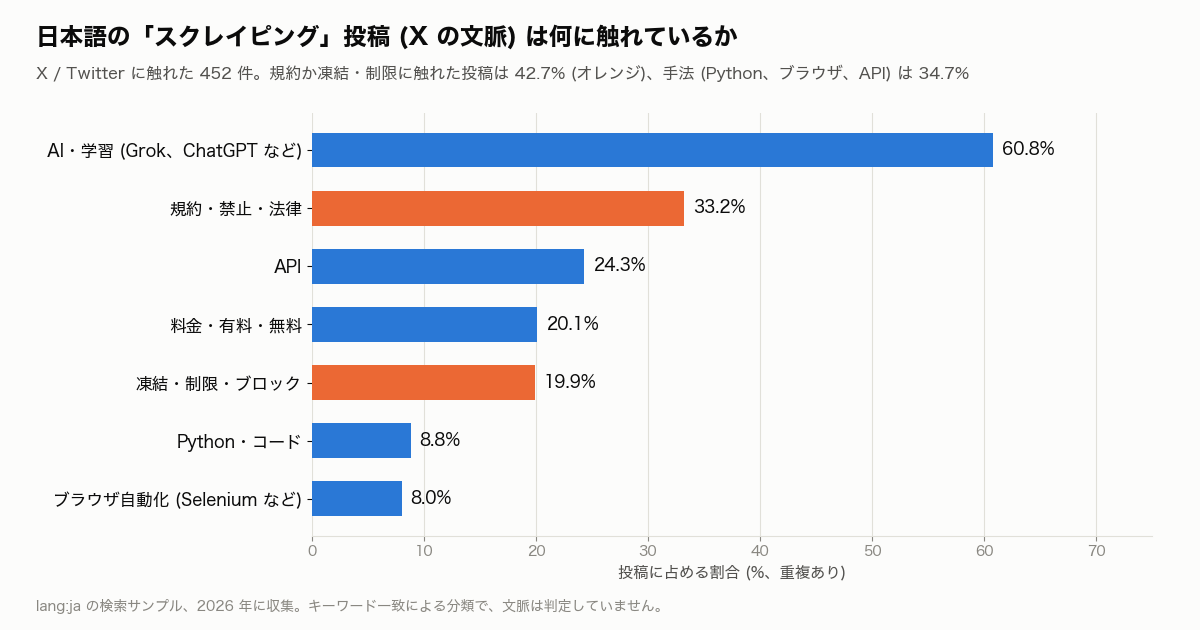
42.7% (X に触れた 452 件中、2026 年に収集)。Python やブラウザ自動化などの手法に触れた投稿は 34.7% でした。
なぜ X (Twitter) のスクレイピングは動かなくなったのか — 2023 年のログイン必須化
2023 年 6 月 30 日、Twitter (当時) はログインしていない閲覧者にツイートを表示しなくなりました。Engadget の 2023 年 7 月 1 日の記事によると、Elon Musk 氏はこれを「Temporary emergency measure」と説明し、「We were getting data pillaged so much that it was degrading service for normal users!」と投稿しています。同じ日には、認証済みアカウントは 1 日 6,000 件、未認証は 600 件、新しい未認証アカウントは 300 件までしか投稿を読めないという一時的な閲覧上限も発表されました (上限はその週末のうちに引き上げられています)。
この変更で、ログインせずに公開ページや内部の検索 API を読んでいた OSS ツールが一斉に止まりました。snscrape は GitHub の issue #996 (2023 年 6 月 30 日起票) に「All Twitter scrapes are failing: blocked (404)」と報告され、メンテナーは原因をログインウォールの可能性が高いとしたうえで「There is no known workaround at this time, and it's not known whether this will be fixable.」と書いています。この issue は現在もオープンのままピン留めされており、PyPI の最新版は 0.7.0.20230622 (2023 年 6 月 22 日) から更新されていません。
twint は、GitHub 上で「This repository was archived by the owner on Mar 30, 2023. It is now read-only.」と表示されており、ログイン必須化より前にメンテナンスが終わっています。ネット上の古い日本語記事には今も snscrape や twint の使い方が残っていますが、2026 年時点でそのまま動くことは期待できません。
残っている「スクレイピング」は、ログイン済みのブラウザを Selenium や Playwright で動かし、画面や画面の裏で呼ばれる内部 API の応答を読む方法です。ツール自体は活発にメンテナンスされていますが、次の章で見るとおり、X の規約との関係とアカウントのリスクが大きな論点になります。
X の利用規約はスクレイピングをどう扱っているか
X の利用規約の日本語版 (x.com/ja/tos) は、「本サービスの悪用」の項で 「本サービスへのクローリングまたはスクレイピングを、当社による事前の書面での同意がないまま行うことは明示的に禁止されています」 と定めています。英語版の該当文は「crawling or scraping the Services in any form, for any purpose without our prior written consent is expressly prohibited」です。TechCrunch は 2023 年 9 月の記事で、この「事前の書面による同意」の文言が加わったと報じています。それ以前の規約は、robots.txt に従うクローリングを認める書き方でした。
同じ日本語版の規約には「損害賠償金」の項があり、24 時間以内に 100 万件を超えるポストをリクエスト、閲覧、またはアクセスした場合、「ポスト100万件あたり15,000米ドルの予定損害賠償額を負担することに同意するものとします」 と書かれています (EU / EFTA / 英国向けはユーロ建て)。規約違反をそそのかした場合も責任を負う、という書き方になっています。
ブラウザ自動化の場合。 ログインしたアカウントで画面を読む行為は、規約上は「事前の書面での同意がない」スクレイピングにあたります。アカウントとして動くため、X が自動化の兆候とみなせば、レート制限、ロック、凍結の対象になりえます。
公式 X API の場合。 X が提供する正規の手段なので、開発者規約と料金の範囲で使う限り、スクレイピング禁止の条項とは別の扱いです。
第三者 API の場合。 利用者は API 提供元の規約に同意して、提供元からデータを受け取ります。どのように X のデータを取得しているか、どこまで再配布できるかは提供元ごとに異なるため、契約前に提供元の規約と、データを使う用途について X の規約を確認してください。
この記事は法的助言ではありません。商用の収集や、収集したデータの公開・販売を予定している場合は、弁護士に相談してください。
日本の著作権法 第30条の4 は何を定めているか (一次資料の範囲で)
日本の開発者からよく出る質問が「情報解析のための収集なら著作権法上は問題ないのか」です。e-Gov 法令検索の著作権法 (昭和四十五年法律第四十八号) 第三十条の四は、冒頭で「著作物は、次に掲げる場合その他の当該著作物に表現された思想又は感情を自ら享受し又は他人に享受させることを目的としない場合には、その必要と認められる限度において、いずれの方法によるかを問わず、利用することができる。」と定めています。
第二号には「情報解析(多数の著作物その他の大量の情報から、当該情報を構成する言語、音、影像その他の要素に係る情報を抽出し、比較、分類その他の解析を行うことをいう。…)の用に供する場合」が挙げられています。一方で、条文の最後には「ただし、当該著作物の種類及び用途並びに当該利用の態様に照らし著作権者の利益を不当に害することとなる場合は、この限りでない。」というただし書きがあります。
ここで押さえておきたいのは、著作権法と X の利用規約は別の問題だという点です。 第30条の4 は著作権の制限に関する規定で、X との契約 (利用規約) で禁止されている行為を許可するものではありません。また、個人のプロフィールや投稿を扱う場合は個人情報保護法の論点もあります。どこまで許されるかは用途と方法によって変わるため、この記事では条文の紹介にとどめ、判断は弁護士に相談することをおすすめします。
日本語の「スクレイピング」投稿 500 件の分析 — 話題の中心は AI と規約
日本のユーザーが X のスクレイピングについて何を投稿しているかを確かめるため、/twitter/tweet/advanced_search (queryType=Latest) で スクレイピング (Twitter OR ツイッター OR X OR ツイート OR ポスト) lang:ja を検索し、直近の投稿 500 件を 2026 年に収集しました。そのうち本文で X / Twitter に触れていた 452 件 (90.4%) を対象に、キーワードで話題を分類しています (1 件が複数の話題に入ります)。
目立つのは、手法より「AI」と「規約」です。 X の文脈の投稿のうち 60.8% が AI や学習に触れており、規約・禁止・法律に触れた投稿は 33.2% でした。規約か凍結・制限のどちらかに触れた投稿は 42.7% に達し、Python、ブラウザ自動化、API のいずれかの手法に触れた投稿 (34.7%) を上回っています。日本語の会話では、「どうやって取るか」より「取ってよいのか、取られるのか」が中心になっていることがわかります。
Python に触れた投稿は 8.8%、Selenium などのブラウザ自動化は 8.0% と少数派です。一方で API には 24.3%、料金には 20.1% が触れており、「API は高い、スクレイピングは禁止」という板挟みを書いた投稿が繰り返し見られました。返信の割合は 17.2%、リンクを含む投稿は 25.6%、いいね数の中央値は 6、表示回数の中央値は 1,162 です。
投稿が集中した時期 — 2024 年 10〜11 月の規約改定と AI 学習
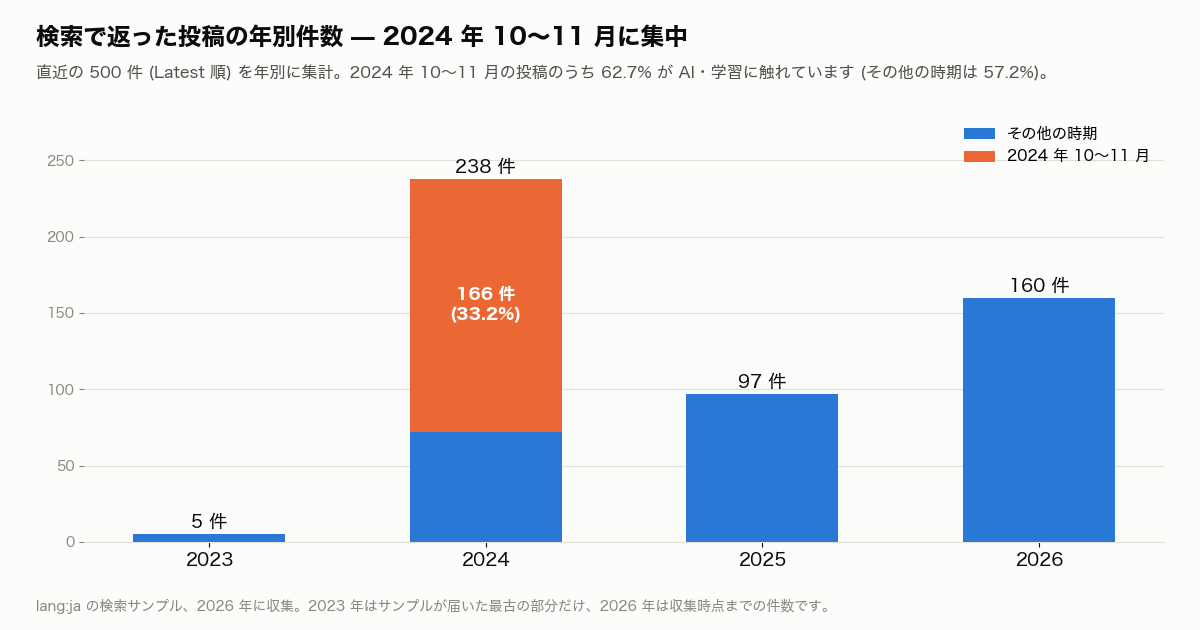
同じ 500 件を年別に数えると、2024 年が 238 件、2025 年が 97 件、2026 年 (収集時点まで) が 160 件でした。目立つのは 2024 年 10〜11 月の集中で、この 2 か月だけで 166 件、サンプル全体の 33.2% を占めています。
この時期は、X が 2024 年 10 月に利用規約の改定を公表し、投稿を AI の学習に使えることや、先に紹介した 100 万件あたり $15,000 の損害賠償条項が話題になった時期と重なります (The Register の 2024 年 10 月 18 日の記事などが報じています)。この 2 か月の投稿のうち 62.7% が AI・学習に触れており、それ以外の時期の 57.2% より高くなっています。「自分の投稿がスクレイピングや AI 学習に使われるのか」という、取られる側の関心が大きかったことがうかがえます。
開発者の立場で読むと、X のスクレイピングをめぐる話題は規約の変更をきっかけに急増しやすく、ルールが変わる前提でデータ取得の仕組みを設計しておく必要がある、ということです。規約の文言や料金は変わることがあるため、本番運用の前には一次資料を確認してください。
3 つのルートを比較 — ブラウザ自動化、公式 X API、第三者 API
X のデータを集める方法を、1,000 件あたりのコスト、準備、壊れやすさ、規約上の位置づけで並べます。公式 X API の単価は docs.x.com の料金ページ (docs.x.com/x-api/getting-started/pricing)、TwitterAPI.io の単価は料金ページの値です。
ブラウザ自動化 (Selenium / Playwright)。 ツールは無料で、PyPI では Selenium 4.53.0、Playwright 1.65.2 が公開されています。ただし X ではログインしたアカウントが必要で、画面の構造や画面の裏で呼ばれる内部 API は予告なく変わります。前の章のとおり規約では事前の書面同意なしのスクレイピングが禁止されており、アカウントのロックや凍結のリスクもあります。この記事では X 向けのスクレイピングコードは載せていません。
公式 X API。 docs.x.com の料金ページでは、Post 読み取りが 1 件 $0.005、ユーザー読み取りが 1 件 $0.010、フォロー / フォロワー読み取りが 1 件 $0.010 です。pay-per-usage は月次の請求サイクルあたり 300 万件の Post 読み取りが上限で、それ以上は Enterprise になります。最初の対象カードの登録で $20 分のクレジット、初回の自動チャージに最大 $50 のマッチングが付きます。料金の詳細は料金ガイドの記事を参照してください。
第三者 API (TwitterAPI.io)。 API キーをヘッダー X-API-Key に付けて呼ぶだけで、X のアカウントや OAuth は不要です。返ってきたツイート 1,000 件あたり $0.15 (1 件 15 クレジット) で、公式の Post 読み取り $5.00 と比べると、同じ公式料金表に対して約 33 倍の差があります。1 回の呼び出しの最低料金は 15 クレジット ($0.00015) で、これは何も返らなかった検索の料金です。レート制限は初回の支払い前が 0.2 リクエスト / 秒、支払い後が 20 リクエスト / 秒です。
今回の調査で集めた 500 件を例にすると、データ費用は TwitterAPI.io で約 $0.075、同じ件数を公式の Post 読み取り単価で読むと $2.50 です。
Python で日本語の投稿を集める — スクレイピングの代わりに API を使う
スクレイピングで多い用途は「キーワードやアカウントの投稿を、日付や反応数と一緒に表にしたい」というものです。この用途なら、/twitter/tweet/advanced_search に X の検索演算子 (lang:ja、from:、since: / until:、min_faves:、-filter:replies など) を渡すだけで、HTML の解析なしに JSON で受け取れます。
レスポンスの形。 検索結果はトップレベルの tweets[] に入り、1 ページ最大 20 件です。続きがある場合は has_next_page が true になり、next_cursor を次の呼び出しの cursor に渡します。各ツイートには id、text、createdAt ("Thu Oct 16 12:34:56 +0000 2026" の形式)、lang、likeCount、retweetCount、replyCount、viewCount、author (userName、followers など) が入っています。
特定アカウントの投稿。 企業や公式アカウントの直近の投稿は /twitter/user/last_tweets (userName=...) で取得できます。こちらは data.tweets[] に入る点だけ検索と異なります。プロフィールは /twitter/user/info で、1 件 18 クレジット (1,000 件あたり $0.18) です。
エラー処理。 エラーの内容は msg に入ります。存在しないユーザーを指定した場合も HTTP 200 で status: "error" と msg: "user not found" が返るため、HTTP ステータスだけでなく status も確認してください。パラメーターが足りない場合は HTTP 400 で、内容は detail に入ります。秒間の上限に達すると HTTP 429 が返るので、少し待ってから再試行します。
ページ下部のコード例は、日本語の投稿を lang:ja で検索し、最大件数 (max_tweets) で費用の上限を決めてから集める最小の例です。endpoint の一覧は API の概要ページ、基本的な使い方は使い方ガイドの記事にまとめています。
# 特定アカウントの直近の投稿 (data.tweets に入る点に注意)
import os
import requests

r = requests.get(
    "https://api.twitterapi.io/twitter/user/last_tweets",
    params={"userName": "XDevelopers"},
    headers={"X-API-Key": os.environ["TWITTERAPI_IO_KEY"]},
    timeout=30,
)
r.raise_for_status()
body = r.json()
for t in (body.get("data") or {}).get("tweets", []):
    print(t["createdAt"], t.get("likeCount"), (t.get("text") or "")[:60])
print("has_next_page:", body.get("has_next_page"), "next_cursor:", body.get("next_cursor"))
監視・定期収集のコスト感と、書き込みを自動化する場合の注意
スクレイピングを定期実行していた用途 (キーワードの監視など) を API に置き換える場合、気になるのは「何も見つからなかったときの費用」です。TwitterAPI.io では、何も返らなかった検索は最低料金の 15 クレジット ($0.00015) です。5 分ごとに 1 か月チェックすると合計約 $1.30、60 秒ごと (43,200 回) なら $6.48 で、投稿が見つかった場合は返ってきたツイート 1,000 件あたり $0.15 が加わります。
書き込み (投稿、いいね、フォローなど) も自動化したい場合。 TwitterAPI.io では /twitter/user_login_v2 で 1 回ログインし ($0.10、プロキシは利用者が用意)、返ってきた login_cookies を使って /twitter/create_tweet_v2 や /twitter/follow_user_v2 などを 1 操作 60 クレジット ($0.0006) で呼び出します。操作はそのアカウントとして行われるため、X によってレート制限、ロック、凍結を受ける可能性があります。人間らしいペースを保ち、セッションの再ログインが必要になる場合もあります。料金は HTTP 200 が返った呼び出しごとに発生します。
読み取りだけなら X のアカウントは不要です。料金プラン (Starter $29、Builder $99、Pro $199、Scale $499、Business $1,499 / 月) とクレジットの仕組みは料金ページを確認してください。新規アカウントには、自動のボットチェックを通過した場合に最大 $1 分の無料クレジット (上限 100,000 クレジット、カード不要、1 人またはネットワークにつき 1 回、31 日で失効) が付与されます。購入したクレジットは失効しません。
調査方法 (How we collected this)
問い: 日本語で X のスクレイピングに触れる投稿は、手法 (Python、ブラウザ自動化、API)、規約・法律、凍結・制限、料金、AI・学習のどの話題に触れているか。いつ投稿が集中したか。
クエリ: /twitter/tweet/advanced_search (queryType=Latest) で スクレイピング (Twitter OR ツイッター OR X OR ツイート OR ポスト) lang:ja を検索し、next_cursor で 25 ページ (500 件) を取得しました。
期間とサンプル: 2026 年に収集。直近の投稿から順に取得したため、サンプルは約 2.9 年分に広がっています。重複とリツイートはありませんでした。本文で X / Twitter に触れた 452 件を話題の集計に使っています。成功したリクエストは 25 回、データ費用は約 $0.075 でした (共有のレート制限で一時的に HTTP 503 が返った呼び出しは再試行しています)。
この調査でわからないこと: 話題の分類は日本語と英語のキーワード一致によるもので、文脈は判定していません (「X」の一文字一致や、無関係な「制限」も数えます)。検索で返る公開投稿だけが対象で、日本のユーザー全体を代表するものではありません。Latest 順で件数の上限まで取得しているため、年ごとの件数は傾向の目安にとどまります。
プライバシー: 検索で集まった投稿者は個人のため、元データは公開していません。公開しているのは集計値と、ID、URL、本文、ハンドルを除いた匿名化済みの行だけです。
"""日本語の投稿を X (Twitter) から集める — スクレイピングの代わりに TwitterAPI.io の advanced_search を使う例。

使い方: TWITTERAPI_IO_KEY=... python3 ja_search.py
費用: 返ってきたツイート 1,000 件あたり $0.15 (1 回の呼び出しの最低料金は 15 クレジット)。
X のアカウント、OAuth、ブラウザ、HTML の解析は不要です。
"""
import os
import time

import requests

BASE = "https://api.twitterapi.io"
HEADERS = {"X-API-Key": os.environ["TWITTERAPI_IO_KEY"]}


def search(query, max_tweets=200):
    """advanced_search を next_cursor でページ送りし、最大 max_tweets 件を返す。"""
    tweets, cursor = [], ""
    while len(tweets) < max_tweets:
        r = requests.get(
            f"{BASE}/twitter/tweet/advanced_search",
            params={"query": query, "queryType": "Latest", "cursor": cursor},
            headers=HEADERS,
            timeout=30,
        )
        if r.status_code == 429:  # 秒間の上限に達したら少し待つ
            time.sleep(5)
            continue
        r.raise_for_status()
        body = r.json()
        tweets.extend(body.get("tweets", []))
        if not body.get("has_next_page"):
            break
        cursor = body.get("next_cursor", "")
    return tweets[:max_tweets]


tweets = search("(Python OR 機械学習) lang:ja -filter:replies min_faves:10", max_tweets=100)
print(f"取得: {len(tweets)} 件 (データ費用の目安 ${len(tweets) * 0.00015:.4f})")
for t in tweets[:5]:
    a = t.get("author") or {}
    print(t["createdAt"], a.get("userName"), t.get("likeCount"), t.get("viewCount"))
    print("  ", (t.get("text") or "").replace("\n", " ")[:80])
実装を検討中ですか?無料の試用クレジットで E2E テストまで実行できます — Google サインインのみ、カード登録不要。 API キーを取得 →
よくある質問
X (Twitter) のスクレイピングは違法ですか?
日本の法律上の評価は用途と方法によって変わるため、一概には言えません。著作権法 第30条の4 は情報解析のための利用を認めていますが、「著作権者の利益を不当に害することとなる場合」は除かれ、またこれは X の利用規約とは別の問題です。X の利用規約は、事前の書面での同意がないクローリングとスクレイピングを明示的に禁止しています。商用の収集やデータの公開を予定している場合は弁護士に相談してください。
snscrape や twint はもう使えないのですか?
snscrape は GitHub の issue #996 で「All Twitter scrapes are failing」と報告されたままで、メンテナーは既知の解決策はないと書いています。PyPI の最新版は 0.7.0.20230622 です。twint は 2023 年 3 月 30 日にリポジトリがアーカイブされ、読み取り専用になっています。どちらも X のデータ取得の手段としては期待できません。
なぜ 2023 年からスクレイピングができなくなったのですか?
2023 年 6 月 30 日に、ログインしていない閲覧者にツイートが表示されなくなったためです。Elon Musk 氏はこれを、データの大量取得への一時的な緊急措置と説明し、翌日には 1 日に読める投稿数の上限も発表されました。ログインなしで公開ページを読んでいた OSS ツールはこの変更で止まりました。
Selenium や Playwright なら X のスクレイピングはできますか?
ログインしたブラウザを自動操作すれば画面を読むことは技術的には可能ですが、X の利用規約は事前の書面同意なしのスクレイピングを禁止しています。アカウントとして動くため、ロックや凍結の対象になりえ、画面や内部 API の変更で頻繁に止まります。継続的にデータが必要なら、公式 X API か第三者 API を検討してください。
公式 X API でツイートを取得するといくらかかりますか?
docs.x.com の料金ページでは、Post 読み取り 1 件 $0.005 (1,000 件で $5)、ユーザー読み取り 1 件 $0.010 です。pay-per-usage は月次の請求サイクルあたり 300 万件の Post 読み取りが上限で、それ以上は Enterprise になります。料金は変わることがあるため、契約前に公式ページを確認してください。
スクレイピングの代わりに使える API はありますか?
公式 X API のほか、API キーだけで使える第三者 API があります。TwitterAPI.io は返ってきたツイート 1,000 件あたり $0.15 で、X のアカウントや OAuth は不要です。/twitter/tweet/advanced_search に lang:ja などの検索演算子を渡すと、日本語の投稿を JSON で受け取れます。提供元の規約と、データの用途について X の規約も確認してください。
無料で試せますか?
公式 X API は、最初の対象カードを登録してクレジットを購入すると $20 分のクレジットが付きます。TwitterAPI.io では、自動のボットチェックを通過した新規アカウントに最大 $1 分の無料クレジット (上限 100,000 クレジット、カード不要、1 人またはネットワークにつき 1 回、31 日で失効) が付与されます。初回の支払い前のレート制限は 0.2 リクエスト / 秒です。
続けて読む
- X 利用規約 (日本語版)事前の書面での同意がないクローリングとスクレイピングの禁止、ポスト 100 万件あたり 15,000 米ドルの予定損害賠償額の根拠です。
- 著作権法 — e-Gov 法令検索第三十条の四 (享受を目的としない利用、第二号の情報解析、ただし書き) の条文の根拠です。
- snscrape issue #996 — All Twitter scrapes are failing2023 年 6 月 30 日以降 snscrape の Twitter スクレイプが失敗し、既知の解決策がないというメンテナーの説明の根拠です。
- twint — GitHub リポジトリ (アーカイブ済み)2023 年 3 月 30 日にアーカイブされ読み取り専用になっていることの根拠です。
- X API Pricing — docs.x.com 公式料金ページPost 読み取り $0.005、ユーザー読み取り $0.010、月 300 万件の上限、$20 の無料クレジットと最大 $50 のマッチングの根拠です。
- Advanced Search — TwitterAPI.io ドキュメントコード例の endpoint、検索演算子、has_next_page と next_cursor によるページ送りの根拠です。
- X (Twitter) API の概要と endpoint 一覧
- Twitter (X) のデータ取得 API の比較
- X (Twitter) API の代替の選び方と移行手順
- X API の料金プランと従量課金の単価表
- X (Twitter) API のレート制限ガイド
- Twitter (X) API の使い方 (Python の入門)
- Twitter (X) API を無料で使う方法
- TwitterAPI.io の料金とプラン
- API キーを取得する (新規アカウントに最大 $1 分の無料クレジット、ボットチェックあり・31 日で失効、カード不要)
- TwitterAPI.io の endpoint ドキュメント